1. Des composants indépendants à une infrastructure cohérente
Au fil des articles précédents, nous avons installé et configuré plusieurs composants destinés à construire un environnement d'intelligence artificielle autonome. Chacun remplit une fonction particulière : gérer les connexions, exécuter des modèles, conserver des données ou exploiter une base documentaire.
Mais installer plusieurs services ne suffit pas à construire une infrastructure opérationnelle. Leur intérêt apparaît véritablement lorsqu'ils peuvent échanger des informations et coopérer dans la réalisation d'une tâche.
C'est précisément l'objectif de cette dernière étape du guide : comprendre comment les composants de LABO peuvent travailler ensemble et découvrir le rôle de n8n dans cette organisation.
Nous allons donc passer d'une vision centrée sur les applications à une vision centrée sur les échanges. Il ne s'agit plus seulement de savoir ce que chaque service sait faire, mais de comprendre comment les mobiliser dans un processus commun.
Cette représentation est volontairement simplifiée. Tous les services ne doivent pas nécessairement communiquer directement entre eux, ni passer systématiquement par n8n. L'organisation dépend du traitement à réaliser et des interfaces proposées par chaque application.
2. Le rôle de chaque composant dans LABO
Avant de parler de coordination, rappelons les responsabilités des principaux services de notre infrastructure. Cette distinction est importante : un orchestrateur ne remplace pas les applications qu'il coordonne.
| Composant | Fonction dans l'infrastructure |
|---|---|
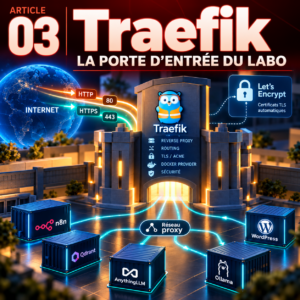
| Traefik | Gérer les connexions entrantes et diriger les requêtes vers les services concernés. |
| n8n | Construire et exécuter les workflows qui coordonnent les opérations. |
| Ollama | Mettre les modèles de langage à disposition des applications et des traitements. |
| AnythingLLM | Gérer les espaces documentaires et proposer une interface pour exploiter les fonctions RAG. |
| Qdrant | Stocker et rechercher les représentations vectorielles utilisées dans les traitements documentaires. |
| PostgreSQL | Stocker les données structurées des applications qui l'utilisent. |
Il faut notamment éviter une confusion : PostgreSQL n'est pas un moteur de recherche vectorielle dans notre architecture. Cette fonction est assurée par Qdrant. De même, Ollama ne gère pas les workflows et n8n ne remplace pas le modèle de langage.
Chaque service apporte une capacité spécifique. L'architecture devient intéressante lorsque ces capacités peuvent être combinées.
3. n8n : le coordinateur des opérations
n8n est une plateforme d'automatisation qui permet de construire des workflows en reliant différentes applications et différents services. Son fonctionnement repose sur des éléments appelés nœuds (nodes). Chaque nœud réalise une opération et transmet éventuellement son résultat au suivant.
Un workflow peut ainsi recevoir une information, la transformer, appeler une API, récupérer une réponse et déclencher une autre opération. Les conditions et les embranchements permettent d'adapter le déroulement du traitement aux données reçues.
Dans notre environnement, n8n peut donc jouer le rôle de coordinateur. Il ne produit pas lui-même les réponses du modèle, ne réalise pas les recherches vectorielles et ne stocke pas nécessairement les documents. Il organise les interventions des services qui possèdent ces fonctions.
La représentation montre un enchaînement simple. Dans n8n, il est possible d'ajouter des conditions, des boucles, des traitements parallèles et des mécanismes de gestion des erreurs. La logique du processus reste définie par le concepteur du workflow.
Pour approfondir la différence entre automatisation, workflow, orchestration et agent IA, consulter l'article Wiki-Soul consacré à ces notions. Le guide se concentre ici sur leur mise en œuvre dans notre infrastructure.
4. Comment les services communiquent-ils ?
Pour qu'un workflow puisse solliciter un autre service, il faut disposer d'un moyen de communication compatible. Dans notre environnement, les échanges reposent principalement sur des interfaces réseau et des API.
Une API (Application Programming Interface) permet à une application de demander une opération à un service, selon des règles et un format définis. Une requête peut transmettre des paramètres, des données ou une instruction. Le service renvoie ensuite une réponse.
Par exemple, n8n peut envoyer une requête HTTP à une API Ollama pour demander la génération d'un texte. Le service reçoit la demande, sollicite le modèle concerné et renvoie le résultat. n8n peut ensuite exploiter cette réponse dans la suite du workflow.
Le même principe peut être utilisé pour communiquer avec d'autres applications, à condition qu'elles proposent une interface adaptée et que les paramètres de connexion soient correctement configurés.
Une communication entre deux services nécessite plusieurs éléments : une adresse accessible, un port, une interface compatible et, lorsque cela est nécessaire, une authentification. Une API peut être disponible sans être accessible depuis tous les environnements réseau.
5. Réseau Docker : distinguer accès public et communication interne
Nos services sont déployés dans des conteneurs Docker. Ils ne communiquent donc pas tous de la même manière avec l'extérieur et entre eux.
Il faut distinguer deux situations :
- Accès externe : un utilisateur ou une application située hors du réseau Docker accède à un service par son domaine ou son adresse publique. Traefik peut alors recevoir la connexion et la diriger vers le conteneur concerné.
- Communication interne : deux conteneurs qui partagent un réseau Docker adapté peuvent communiquer directement en utilisant le nom du service et le port interne correspondant.
Cette distinction est essentielle pour n8n. Une adresse publique utilisée depuis un navigateur n'est pas nécessairement la meilleure adresse à utiliser depuis un autre conteneur. Une communication interne évite souvent de faire sortir les échanges du réseau Docker pour les faire revenir vers le même serveur.
La possibilité de communiquer dépend toutefois de la configuration réelle des réseaux Docker. Deux conteneurs ne peuvent pas nécessairement se joindre simplement parce qu'ils se trouvent sur le même VPS.
Le schéma représente deux chemins distincts. Traefik gère les connexions entrantes destinées aux services exposés. Les échanges internes entre conteneurs peuvent utiliser les réseaux Docker sans passer par les domaines publics.
Pour les procédures de configuration, il faudra toujours vérifier les noms de services, les réseaux, les ports internes et les règles d'exposition dans les fichiers Compose de l'installation concernée.
6. Un exemple de coopération : exploiter notre chaîne RAG
L'article précédent a introduit le principe du RAG et ses deux approches de mise en œuvre. Nous disposons donc d'un exemple particulièrement intéressant pour comprendre comment n8n peut s'intégrer dans notre environnement.
Imaginons qu'un utilisateur pose une question concernant un document technique. Le système doit retrouver les informations pertinentes, les transmettre au modèle et produire une réponse contextualisée.
Dans une architecture utilisant AnythingLLM, Ollama et Qdrant, ces fonctions sont déjà réparties entre plusieurs composants. n8n peut intervenir pour déclencher et coordonner certaines opérations autour de cette chaîne, sans avoir à reconstruire le mécanisme RAG.
Ce schéma décrit une répartition fonctionnelle simplifiée. Dans la pratique, AnythingLLM peut gérer lui-même les appels au moteur d'embedding, la recherche vectorielle et la génération via Ollama. n8n n'a donc pas besoin de contacter directement Qdrant et Ollama pour chaque interrogation.
Une autre approche consiste à construire une chaîne RAG indépendante, par exemple avec Python, Ollama et Qdrant. Dans ce cas, n8n peut solliciter le programme ou l'interface mise à disposition par cette chaîne, selon la manière dont elle a été développée.
L'intérêt de cette architecture est de conserver les responsabilités séparées. Le système RAG s'occupe de la recherche et de la génération contextualisée. n8n peut gérer ce qui précède ou ce qui suit : réception d'une demande, contrôle de paramètres, transmission à un autre service, notification ou archivage du résultat.
7. Orchestration et agents IA : une évolution possible
n8n ne se limite pas à relier des services dans un ordre défini. La plateforme propose également des fonctions permettant d'intégrer des composants d'intelligence artificielle dans les workflows, notamment des agents capables de sélectionner des outils en fonction d'une demande.
Il faut cependant distinguer deux niveaux de fonctionnement. Dans un workflow classique, les opérations et les conditions sont définies à l'avance. Dans un système agentique, une partie des décisions est confiée au modèle, qui peut choisir parmi les outils mis à sa disposition.
Ces deux approches peuvent être associées. n8n peut conserver la coordination générale et déléguer une opération particulière à un agent IA. Celui-ci analyse la demande, choisit un outil autorisé et renvoie son résultat au workflow.
Cette organisation permet d'introduire progressivement des capacités agentiques sans abandonner le contrôle du processus. Les étapes sensibles peuvent rester soumises à des règles explicites ou à une validation humaine.
Pour approfondir la différence entre automatisation, orchestration et agents IA, le Wiki-Soul constitue le complément théorique de cet article. La mise en pratique des fonctions agentiques sera abordée dans les expérimentations ultérieures.
8. Sécurité et maîtrise des échanges
Faire communiquer plusieurs services implique également de maîtriser les accès et les données qui circulent entre eux. Un workflow peut disposer d'identifiants permettant d'interroger une API, de consulter une base ou de déclencher une opération. Ces autorisations doivent être limitées aux besoins réels du traitement.
Quelques principes doivent guider la configuration :
- Limiter l'exposition : ne rendre accessibles depuis Internet que les services qui doivent réellement l'être.
- Protéger les API : utiliser les mécanismes d'authentification proposés par les services concernés.
- Protéger les secrets : ne pas inscrire les mots de passe et clés API directement dans les workflows ou dans des fichiers partagés.
- Limiter les permissions : chaque connexion doit disposer uniquement des droits nécessaires.
- Surveiller les exécutions : conserver les informations utiles au diagnostic des erreurs et aux vérifications.
- Contrôler les actions sensibles : prévoir une validation avant toute opération susceptible de modifier ou supprimer des données importantes.
Cette maîtrise est d'autant plus importante lorsque des agents IA sont introduits dans les workflows. Un agent ne doit pas disposer automatiquement de toutes les capacités accessibles à n8n. Les outils et les autorisations doivent être définis en fonction de sa mission.
9. Une infrastructure prête à évoluer
Avec cette dernière étape, notre environnement LABO dispose des principaux éléments nécessaires à la construction de processus automatisés intégrant des services d'intelligence artificielle.
Nous avons séparé les fonctions : routage des connexions, exécution des modèles, recherche documentaire, stockage des données et orchestration. Cette organisation modulaire permet de faire évoluer un composant sans devoir repenser systématiquement toute l'infrastructure.
La prochaine étape consistera à mettre ces possibilités en pratique à travers des expérimentations indépendantes. Elles permettront de construire des workflows simples, de vérifier les échanges réels entre services et de progresser vers des systèmes intégrant des agents IA.
L'objectif n'est pas de tout automatiser immédiatement. Il est de disposer d'une base suffisamment claire, maîtrisée et évolutive pour ajouter de nouvelles fonctions au fur et à mesure des besoins.
À retenir
Les composants de LABO possèdent chacun une fonction spécialisée. n8n permet de les coordonner dans des workflows et d'organiser les échanges entre services. Les modèles IA et les agents peuvent ensuite être intégrés à ces processus. L'intérêt de l'architecture réside dans la complémentarité des composants, leur modularité et la maîtrise de leurs interactions.
Après avoir installé les premiers composants de LABO, nous allons ajouter un service chargé de coordonner leurs opérations : n8n. Cette plateforme d'automatisation permet de relier différents outils, API et traitements au sein de scénarios appelés workflows.
Nous allons installer n8n dans un conteneur Docker indépendant, le raccorder au reverse proxy Traefik et lui attribuer un accès HTTPS. L'objectif de cette étape est d'obtenir une installation fonctionnelle. La création des premiers workflows sera abordée séparément.
1. Préparer l'environnement
Comme pour les autres services de LABO, n8n disposera de son propre répertoire. Nous conservons ainsi une organisation modulaire : chaque application possède sa configuration et ses données.
Créons le répertoire puis plaçons-nous dedans.
mkdir -p /opt/labo/n8n
cd /opt/labo/n8n
Nous allons utiliser deux fichiers : .env, qui contiendra les paramètres propres à l'environnement, et docker-compose.yml, qui décrira le conteneur et son raccordement à l'infrastructure.
2. Préparer les variables d'environnement
Le fichier .env permet de séparer les paramètres propres à l'installation du fichier Compose. Il contiendra notamment le nom de domaine et une clé de chiffrement utilisée par n8n pour protéger les identifiants enregistrés.
Générons une clé aléatoire de 32 octets avec OpenSSL. La commande affiche une chaîne hexadécimale que nous conserverons pour la configuration de n8n.
Cette clé doit être conservée durablement. Si elle est perdue ou remplacée, les identifiants chiffrés précédemment enregistrés peuvent devenir inutilisables.
openssl rand -hex 32
Créons maintenant le fichier .env. Remplaçons le domaine d'exemple par celui qui sera réellement utilisé et reportons la clé générée précédemment.
nano .env# Domaine public de n8n
N8N_DOMAIN=n8n.exemple.be
# Clé de chiffrement générée avec openssl
N8N_ENCRYPTION_KEY=REMPLACER_PAR_LA_CLE_GENEREELe fichier contient une donnée sensible. Il doit rester privé et ne doit pas être publié dans un dépôt Git.
3. Créer le fichier Docker Compose
Docker Compose va décrire le conteneur n8n, ses paramètres, son stockage persistant et son raccordement au réseau de Traefik. Nous utilisons ici l'image officielle n8nio/n8n.
Pour cette première installation, n8n utilisera SQLite, sa base de données intégrée. Les données seront conservées dans un volume Docker indépendant du cycle de vie du conteneur.
Créons le fichier de configuration dans le répertoire de n8n. Il contiendra la définition complète du service et les règles permettant à Traefik de le rendre accessible en HTTPS.
nano docker-compose.ymlservices:
n8n:
image: n8nio/n8n:2.32.7
container_name: n8n
restart: unless-stopped
environment:
- N8N_HOST=${N8N_DOMAIN}
- N8N_PORT=5678
- N8N_PROTOCOL=https
- N8N_EDITOR_BASE_URL=https://${N8N_DOMAIN}/
- WEBHOOK_URL=https://${N8N_DOMAIN}/
- N8N_PROXY_HOPS=1
- N8N_SECURE_COOKIE=true
- N8N_ENCRYPTION_KEY=${N8N_ENCRYPTION_KEY}
- GENERIC_TIMEZONE=Europe/Brussels
- TZ=Europe/Brussels
- N8N_ENFORCE_SETTINGS_FILE_PERMISSIONS=true
volumes:
- n8n_data:/home/node/.n8n
networks:
- proxy
labels:
- traefik.enable=true
- traefik.docker.network=traefik
- traefik.http.routers.n8n.rule=Host(`${N8N_DOMAIN}`)
- traefik.http.routers.n8n.entrypoints=websecure
- traefik.http.routers.n8n.tls=true
- traefik.http.routers.n8n.tls.certresolver=le
- traefik.http.services.n8n.loadbalancer.server.port=5678
volumes:
n8n_data:
networks:
proxy:
external: true
name: traefikQuelques paramètres méritent d'être identifiés :
- 5678 : port interne sur lequel n8n écoute dans son conteneur.
- n8n_data : volume persistant qui conserve les données de l'application.
- N8N_ENCRYPTION_KEY : clé utilisée pour chiffrer les données sensibles.
- N8N_PROXY_HOPS : indique à n8n qu'il se trouve derrière un proxy inverse.
- WEBHOOK_URL : définit l'adresse publique utilisée pour construire les URL des webhooks.
- Europe/Brussels : fixe le fuseau horaire utilisé par les traitements planifiés.
Les labels Traefik déclarent un routeur HTTPS pour le domaine de n8n et indiquent le port interne du service. Le nom du réseau Docker et celui du résolveur de certificats sont des valeurs provisoires à adapter à notre installation réelle.
4. Vérifier la configuration
Avant de lancer le conteneur, demandons à Docker Compose de vérifier et d'interpréter le fichier de configuration.
Cette commande permet notamment de repérer une erreur de syntaxe YAML ou une variable d'environnement manquante. Attention : elle peut afficher les valeurs sensibles développées depuis le fichier .env.
docker compose config
Vérifions également que le réseau Docker déclaré dans Compose existe bien. Dans notre exemple, son nom est traefik.
Si le réseau n'existe pas, ne le créons pas immédiatement : il faut d'abord identifier celui réellement utilisé par le conteneur Traefik. Les deux services doivent partager un réseau Docker pour communiquer.
docker network inspect traefik5. Démarrer n8n
Lorsque la configuration est cohérente et que le réseau partagé existe, nous pouvons télécharger l'image et démarrer le service.
La première commande récupère l'image si elle n'est pas déjà présente. La seconde crée le conteneur et son volume de données. L'option -d laisse le service fonctionner en arrière-plan.
docker compose pull
docker compose up -d
6. Contrôler le fonctionnement
Vérifions d'abord que le conteneur est bien démarré. Son état doit apparaître comme actif.
docker compose psConsultons ensuite les journaux de démarrage. Ils permettent de repérer les erreurs de configuration, les problèmes de connexion ou les difficultés d'initialisation.
docker compose logs --tail=100 n8nSi le conteneur fonctionne correctement, ouvrons le domaine configuré dans le navigateur. Traefik doit recevoir la requête HTTPS, la transmettre à n8n et présenter un certificat valide.
Lors du premier accès, n8n demande la création du compte propriétaire. Ce compte permet d'administrer l'instance et de créer les premiers workflows.
7. Vérifier la persistance des données
Un conteneur peut être supprimé et recréé sans que les données de l'application disparaissent, à condition qu'elles soient stockées dans un volume persistant.
Vérifions ce comportement avec un redémarrage du service.
docker compose restart
docker compose ps
Après le redémarrage, reconnectons-nous à l'interface. Le compte propriétaire et les paramètres de l'instance doivent toujours être présents. Cette vérification confirme que les données sont conservées dans le volume Docker.
À retenir
n8n est installé comme un service indépendant, stocke ses données dans un volume persistant et utilise Traefik pour son accès HTTPS. L'infrastructure dispose maintenant d'un outil d'orchestration prêt à relier ses différents composants. La prochaine partie montrera comment ces services peuvent coopérer.
Après avoir installé les premiers composants de LABO, nous allons ajouter un service chargé de coordonner leurs opérations : n8n. Cette plateforme d'automatisation permet de relier différents outils, API et traitements au sein de scénarios appelés workflows.
Nous allons installer n8n dans un conteneur Docker indépendant, le raccorder au reverse proxy Traefik et lui attribuer un accès HTTPS. L'objectif de cette étape est d'obtenir une installation fonctionnelle. La création des premiers workflows sera abordée séparément.
1. Préparer l'environnement
Comme pour les autres services de LABO, n8n disposera de son propre répertoire. Nous conservons ainsi une organisation modulaire : chaque application possède sa configuration et ses données.
Créons le répertoire puis plaçons-nous dedans.
mkdir -p /opt/labo/n8n
cd /opt/labo/n8n
Nous allons utiliser deux fichiers : .env, qui contiendra les paramètres propres à l'environnement, et docker-compose.yml, qui décrira le conteneur et son raccordement à l'infrastructure.
2. Préparer les variables d'environnement
Le fichier .env permet de séparer les paramètres propres à l'installation du fichier Compose. Il contiendra notamment le nom de domaine et une clé de chiffrement utilisée par n8n pour protéger les identifiants enregistrés.
Générons une clé aléatoire de 32 octets avec OpenSSL. La commande affiche une chaîne hexadécimale que nous conserverons pour la configuration de n8n.
Cette clé doit être conservée durablement. Si elle est perdue ou remplacée, les identifiants chiffrés précédemment enregistrés peuvent devenir inutilisables.
openssl rand -hex 32
Créons maintenant le fichier .env. Remplaçons le domaine d'exemple par celui qui sera réellement utilisé et reportons la clé générée précédemment.
nano .env# Domaine public de n8n
N8N_DOMAIN=n8n.exemple.be
# Clé de chiffrement générée avec openssl
N8N_ENCRYPTION_KEY=REMPLACER_PAR_LA_CLE_GENEREELe fichier contient une donnée sensible. Il doit rester privé et ne doit pas être publié dans un dépôt Git.
3. Créer le fichier Docker Compose
Docker Compose va décrire le conteneur n8n, ses paramètres, son stockage persistant et son raccordement au réseau de Traefik. Nous utilisons ici l'image officielle n8nio/n8n.
Pour cette première installation, n8n utilisera SQLite, sa base de données intégrée. Les données seront conservées dans un volume Docker indépendant du cycle de vie du conteneur.
Créons le fichier de configuration dans le répertoire de n8n. Il contiendra la définition complète du service et les règles permettant à Traefik de le rendre accessible en HTTPS.
nano docker-compose.ymlservices:
n8n:
image: n8nio/n8n:2.32.7
container_name: n8n
restart: unless-stopped
environment:
- N8N_HOST=${N8N_DOMAIN}
- N8N_PORT=5678
- N8N_PROTOCOL=https
- N8N_EDITOR_BASE_URL=https://${N8N_DOMAIN}/
- WEBHOOK_URL=https://${N8N_DOMAIN}/
- N8N_PROXY_HOPS=1
- N8N_SECURE_COOKIE=true
- N8N_ENCRYPTION_KEY=${N8N_ENCRYPTION_KEY}
- GENERIC_TIMEZONE=Europe/Brussels
- TZ=Europe/Brussels
- N8N_ENFORCE_SETTINGS_FILE_PERMISSIONS=true
volumes:
- n8n_data:/home/node/.n8n
networks:
- proxy
labels:
- traefik.enable=true
- traefik.docker.network=traefik
- traefik.http.routers.n8n.rule=Host(`${N8N_DOMAIN}`)
- traefik.http.routers.n8n.entrypoints=websecure
- traefik.http.routers.n8n.tls=true
- traefik.http.routers.n8n.tls.certresolver=le
- traefik.http.services.n8n.loadbalancer.server.port=5678
volumes:
n8n_data:
networks:
proxy:
external: true
name: traefikQuelques paramètres méritent d'être identifiés :
- 5678 : port interne sur lequel n8n écoute dans son conteneur.
- n8n_data : volume persistant qui conserve les données de l'application.
- N8N_ENCRYPTION_KEY : clé utilisée pour chiffrer les données sensibles.
- N8N_PROXY_HOPS : indique à n8n qu'il se trouve derrière un proxy inverse.
- WEBHOOK_URL : définit l'adresse publique utilisée pour construire les URL des webhooks.
- Europe/Brussels : fixe le fuseau horaire utilisé par les traitements planifiés.
Les labels Traefik déclarent un routeur HTTPS pour le domaine de n8n et indiquent le port interne du service. Le nom du réseau Docker et celui du résolveur de certificats sont des valeurs provisoires à adapter à notre installation réelle.
4. Vérifier la configuration
Avant de lancer le conteneur, demandons à Docker Compose de vérifier et d'interpréter le fichier de configuration.
Cette commande permet notamment de repérer une erreur de syntaxe YAML ou une variable d'environnement manquante. Attention : elle peut afficher les valeurs sensibles développées depuis le fichier .env.
docker compose config
Vérifions également que le réseau Docker déclaré dans Compose existe bien. Dans notre exemple, son nom est traefik.
Si le réseau n'existe pas, ne le créons pas immédiatement : il faut d'abord identifier celui réellement utilisé par le conteneur Traefik. Les deux services doivent partager un réseau Docker pour communiquer.
docker network inspect traefik5. Démarrer n8n
Lorsque la configuration est cohérente et que le réseau partagé existe, nous pouvons télécharger l'image et démarrer le service.
La première commande récupère l'image si elle n'est pas déjà présente. La seconde crée le conteneur et son volume de données. L'option -d laisse le service fonctionner en arrière-plan.
docker compose pull
docker compose up -d
6. Contrôler le fonctionnement
Vérifions d'abord que le conteneur est bien démarré. Son état doit apparaître comme actif.
docker compose psConsultons ensuite les journaux de démarrage. Ils permettent de repérer les erreurs de configuration, les problèmes de connexion ou les difficultés d'initialisation.
docker compose logs --tail=100 n8nSi le conteneur fonctionne correctement, ouvrons le domaine configuré dans le navigateur. Traefik doit recevoir la requête HTTPS, la transmettre à n8n et présenter un certificat valide.
Lors du premier accès, n8n demande la création du compte propriétaire. Ce compte permet d'administrer l'instance et de créer les premiers workflows.
7. Vérifier la persistance des données
Un conteneur peut être supprimé et recréé sans que les données de l'application disparaissent, à condition qu'elles soient stockées dans un volume persistant.
Vérifions ce comportement avec un redémarrage du service.
docker compose restart
docker compose ps
Après le redémarrage, reconnectons-nous à l'interface. Le compte propriétaire et les paramètres de l'instance doivent toujours être présents. Cette vérification confirme que les données sont conservées dans le volume Docker.
À retenir
n8n est installé comme un service indépendant, stocke ses données dans un volume persistant et utilise Traefik pour son accès HTTPS. L'infrastructure dispose maintenant d'un outil d'orchestration prêt à relier ses différents composants. La prochaine partie montrera comment ces services peuvent coopérer.
1. Des composants indépendants à une infrastructure cohérente
Au fil des articles précédents, nous avons installé et configuré plusieurs composants destinés à construire un environnement d'intelligence artificielle autonome. Chacun remplit une fonction particulière : gérer les connexions, exécuter des modèles, conserver des données ou exploiter une base documentaire.
Mais installer plusieurs services ne suffit pas à construire une infrastructure opérationnelle. Leur intérêt apparaît véritablement lorsqu'ils peuvent échanger des informations et coopérer dans la réalisation d'une tâche.
C'est précisément l'objectif de cette dernière étape du guide : comprendre comment les composants de LABO peuvent travailler ensemble et découvrir le rôle de n8n dans cette organisation.
Nous allons donc passer d'une vision centrée sur les applications à une vision centrée sur les échanges. Il ne s'agit plus seulement de savoir ce que chaque service sait faire, mais de comprendre comment les mobiliser dans un processus commun.
Cette représentation est volontairement simplifiée. Tous les services ne doivent pas nécessairement communiquer directement entre eux, ni passer systématiquement par n8n. L'organisation dépend du traitement à réaliser et des interfaces proposées par chaque application.
2. Le rôle de chaque composant dans LABO
Avant de parler de coordination, rappelons les responsabilités des principaux services de notre infrastructure. Cette distinction est importante : un orchestrateur ne remplace pas les applications qu'il coordonne.
| Composant | Fonction dans l'infrastructure |
|---|---|
| Traefik | Gérer les connexions entrantes et diriger les requêtes vers les services concernés. |
| n8n | Construire et exécuter les workflows qui coordonnent les opérations. |
| Ollama | Mettre les modèles de langage à disposition des applications et des traitements. |
| AnythingLLM | Gérer les espaces documentaires et proposer une interface pour exploiter les fonctions RAG. |
| Qdrant | Stocker et rechercher les représentations vectorielles utilisées dans les traitements documentaires. |
| PostgreSQL | Stocker les données structurées des applications qui l'utilisent. |
Il faut notamment éviter une confusion : PostgreSQL n'est pas un moteur de recherche vectorielle dans notre architecture. Cette fonction est assurée par Qdrant. De même, Ollama ne gère pas les workflows et n8n ne remplace pas le modèle de langage.
Chaque service apporte une capacité spécifique. L'architecture devient intéressante lorsque ces capacités peuvent être combinées.
3. n8n : le coordinateur des opérations
n8n est une plateforme d'automatisation qui permet de construire des workflows en reliant différentes applications et différents services. Son fonctionnement repose sur des éléments appelés nœuds (nodes). Chaque nœud réalise une opération et transmet éventuellement son résultat au suivant.
Un workflow peut ainsi recevoir une information, la transformer, appeler une API, récupérer une réponse et déclencher une autre opération. Les conditions et les embranchements permettent d'adapter le déroulement du traitement aux données reçues.
Dans notre environnement, n8n peut donc jouer le rôle de coordinateur. Il ne produit pas lui-même les réponses du modèle, ne réalise pas les recherches vectorielles et ne stocke pas nécessairement les documents. Il organise les interventions des services qui possèdent ces fonctions.
La représentation montre un enchaînement simple. Dans n8n, il est possible d'ajouter des conditions, des boucles, des traitements parallèles et des mécanismes de gestion des erreurs. La logique du processus reste définie par le concepteur du workflow.
Pour approfondir la différence entre automatisation, workflow, orchestration et agent IA, consulter l'article Wiki-Soul consacré à ces notions. Le guide se concentre ici sur leur mise en œuvre dans notre infrastructure.
4. Comment les services communiquent-ils ?
Pour qu'un workflow puisse solliciter un autre service, il faut disposer d'un moyen de communication compatible. Dans notre environnement, les échanges reposent principalement sur des interfaces réseau et des API.
Une API (Application Programming Interface) permet à une application de demander une opération à un service, selon des règles et un format définis. Une requête peut transmettre des paramètres, des données ou une instruction. Le service renvoie ensuite une réponse.
Par exemple, n8n peut envoyer une requête HTTP à une API Ollama pour demander la génération d'un texte. Le service reçoit la demande, sollicite le modèle concerné et renvoie le résultat. n8n peut ensuite exploiter cette réponse dans la suite du workflow.
Le même principe peut être utilisé pour communiquer avec d'autres applications, à condition qu'elles proposent une interface adaptée et que les paramètres de connexion soient correctement configurés.
Une communication entre deux services nécessite plusieurs éléments : une adresse accessible, un port, une interface compatible et, lorsque cela est nécessaire, une authentification. Une API peut être disponible sans être accessible depuis tous les environnements réseau.
5. Réseau Docker : distinguer accès public et communication interne
Nos services sont déployés dans des conteneurs Docker. Ils ne communiquent donc pas tous de la même manière avec l'extérieur et entre eux.
Il faut distinguer deux situations :
- Accès externe : un utilisateur ou une application située hors du réseau Docker accède à un service par son domaine ou son adresse publique. Traefik peut alors recevoir la connexion et la diriger vers le conteneur concerné.
- Communication interne : deux conteneurs qui partagent un réseau Docker adapté peuvent communiquer directement en utilisant le nom du service et le port interne correspondant.
Cette distinction est essentielle pour n8n. Une adresse publique utilisée depuis un navigateur n'est pas nécessairement la meilleure adresse à utiliser depuis un autre conteneur. Une communication interne évite souvent de faire sortir les échanges du réseau Docker pour les faire revenir vers le même serveur.
La possibilité de communiquer dépend toutefois de la configuration réelle des réseaux Docker. Deux conteneurs ne peuvent pas nécessairement se joindre simplement parce qu'ils se trouvent sur le même VPS.
Le schéma représente deux chemins distincts. Traefik gère les connexions entrantes destinées aux services exposés. Les échanges internes entre conteneurs peuvent utiliser les réseaux Docker sans passer par les domaines publics.
Pour les procédures de configuration, il faudra toujours vérifier les noms de services, les réseaux, les ports internes et les règles d'exposition dans les fichiers Compose de l'installation concernée.
6. Un exemple de coopération : exploiter notre chaîne RAG
L'article précédent a introduit le principe du RAG et ses deux approches de mise en œuvre. Nous disposons donc d'un exemple particulièrement intéressant pour comprendre comment n8n peut s'intégrer dans notre environnement.
Imaginons qu'un utilisateur pose une question concernant un document technique. Le système doit retrouver les informations pertinentes, les transmettre au modèle et produire une réponse contextualisée.
Dans une architecture utilisant AnythingLLM, Ollama et Qdrant, ces fonctions sont déjà réparties entre plusieurs composants. n8n peut intervenir pour déclencher et coordonner certaines opérations autour de cette chaîne, sans avoir à reconstruire le mécanisme RAG.
Ce schéma décrit une répartition fonctionnelle simplifiée. Dans la pratique, AnythingLLM peut gérer lui-même les appels au moteur d'embedding, la recherche vectorielle et la génération via Ollama. n8n n'a donc pas besoin de contacter directement Qdrant et Ollama pour chaque interrogation.
Une autre approche consiste à construire une chaîne RAG indépendante, par exemple avec Python, Ollama et Qdrant. Dans ce cas, n8n peut solliciter le programme ou l'interface mise à disposition par cette chaîne, selon la manière dont elle a été développée.
L'intérêt de cette architecture est de conserver les responsabilités séparées. Le système RAG s'occupe de la recherche et de la génération contextualisée. n8n peut gérer ce qui précède ou ce qui suit : réception d'une demande, contrôle de paramètres, transmission à un autre service, notification ou archivage du résultat.
7. Orchestration et agents IA : une évolution possible
n8n ne se limite pas à relier des services dans un ordre défini. La plateforme propose également des fonctions permettant d'intégrer des composants d'intelligence artificielle dans les workflows, notamment des agents capables de sélectionner des outils en fonction d'une demande.
Il faut cependant distinguer deux niveaux de fonctionnement. Dans un workflow classique, les opérations et les conditions sont définies à l'avance. Dans un système agentique, une partie des décisions est confiée au modèle, qui peut choisir parmi les outils mis à sa disposition.
Ces deux approches peuvent être associées. n8n peut conserver la coordination générale et déléguer une opération particulière à un agent IA. Celui-ci analyse la demande, choisit un outil autorisé et renvoie son résultat au workflow.
Cette organisation permet d'introduire progressivement des capacités agentiques sans abandonner le contrôle du processus. Les étapes sensibles peuvent rester soumises à des règles explicites ou à une validation humaine.
Pour approfondir la différence entre automatisation, orchestration et agents IA, le Wiki-Soul constitue le complément théorique de cet article. La mise en pratique des fonctions agentiques sera abordée dans les expérimentations ultérieures.
8. Sécurité et maîtrise des échanges
Faire communiquer plusieurs services implique également de maîtriser les accès et les données qui circulent entre eux. Un workflow peut disposer d'identifiants permettant d'interroger une API, de consulter une base ou de déclencher une opération. Ces autorisations doivent être limitées aux besoins réels du traitement.
Quelques principes doivent guider la configuration :
- Limiter l'exposition : ne rendre accessibles depuis Internet que les services qui doivent réellement l'être.
- Protéger les API : utiliser les mécanismes d'authentification proposés par les services concernés.
- Protéger les secrets : ne pas inscrire les mots de passe et clés API directement dans les workflows ou dans des fichiers partagés.
- Limiter les permissions : chaque connexion doit disposer uniquement des droits nécessaires.
- Surveiller les exécutions : conserver les informations utiles au diagnostic des erreurs et aux vérifications.
- Contrôler les actions sensibles : prévoir une validation avant toute opération susceptible de modifier ou supprimer des données importantes.
Cette maîtrise est d'autant plus importante lorsque des agents IA sont introduits dans les workflows. Un agent ne doit pas disposer automatiquement de toutes les capacités accessibles à n8n. Les outils et les autorisations doivent être définis en fonction de sa mission.
9. Une infrastructure prête à évoluer
Avec cette dernière étape, notre environnement LABO dispose des principaux éléments nécessaires à la construction de processus automatisés intégrant des services d'intelligence artificielle.
Nous avons séparé les fonctions : routage des connexions, exécution des modèles, recherche documentaire, stockage des données et orchestration. Cette organisation modulaire permet de faire évoluer un composant sans devoir repenser systématiquement toute l'infrastructure.
La prochaine étape consistera à mettre ces possibilités en pratique à travers des expérimentations indépendantes. Elles permettront de construire des workflows simples, de vérifier les échanges réels entre services et de progresser vers des systèmes intégrant des agents IA.
L'objectif n'est pas de tout automatiser immédiatement. Il est de disposer d'une base suffisamment claire, maîtrisée et évolutive pour ajouter de nouvelles fonctions au fur et à mesure des besoins.
À retenir
Les composants de LABO possèdent chacun une fonction spécialisée. n8n permet de les coordonner dans des workflows et d'organiser les échanges entre services. Les modèles IA et les agents peuvent ensuite être intégrés à ces processus. L'intérêt de l'architecture réside dans la complémentarité des composants, leur modularité et la maîtrise de leurs interactions.