1. Qu'est-ce que le RAG ?
Un modèle d'intelligence artificielle possède des connaissances acquises pendant son entraînement. Mais ces connaissances ne comprennent pas nécessairement les documents personnels, les informations internes d'une entreprise ou les données récentes auxquelles il n'a jamais eu accès.
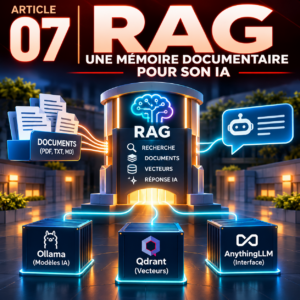
Le RAG (Retrieval-Augmented Generation) apporte une réponse à cette limite. Il permet à un modèle de langage de consulter une collection documentaire avant de formuler sa réponse. Le modèle ne se contente donc plus de mobiliser ses connaissances générales : il reçoit également des informations sélectionnées dans une base documentaire externe.
Le RAG ne modifie pas les connaissances internes du modèle et ne nécessite pas de le réentraîner. Il ajoute une étape de recherche d'informations au moment où une question est posée.
En résumé : le RAG permet à une IA de rechercher des informations dans une bibliothèque documentaire, d'en extraire les passages pertinents et de les utiliser pour construire sa réponse.
2. Les quatre mécanismes fondamentaux
Un système RAG repose sur plusieurs opérations successives. Elles peuvent être réalisées par une application spécialisée ou par différents services coordonnés entre eux.
1. L'extraction des documents
Avant toute recherche, le contenu des documents doit être accessible sous forme de texte. Un système RAG peut traiter différentes sources : fichiers PDF, documents bureautiques, pages web, fichiers Markdown ou simples fichiers texte.
Cette étape consiste à extraire le contenu exploitable. Selon le format, elle peut nécessiter un traitement spécifique. Par exemple, un PDF constitué uniquement d'images peut nécessiter une reconnaissance optique de caractères (OCR) avant que son texte puisse être utilisé.
2. Le découpage en fragments
Un document complet peut être trop volumineux pour être transmis au modèle à chaque question. Le système le découpe donc en portions plus petites, appelées chunks.
Le découpage doit conserver autant que possible le sens des informations. Une séparation au milieu d'une phrase ou d'une explication peut rendre un fragment difficile à interpréter. Il est donc préférable de tenir compte de la structure du document : paragraphes, titres ou sections.
Certains systèmes utilisent également un chevauchement entre deux fragments successifs. Une partie du texte précédent est alors répétée dans le fragment suivant afin de limiter la perte de contexte aux frontières du découpage.
3. La vectorisation et le stockage
Chaque fragment est ensuite transformé en une représentation numérique appelée embedding.
Cette transformation est réalisée par un modèle spécialisé, distinct du modèle qui produira les réponses. L'embedding ne rédige pas de texte : il représente le contenu sous une forme exploitable par un moteur de recherche vectorielle.
Les vecteurs sont enregistrés dans une base de données vectorielle. Le texte d'origine et certaines métadonnées, comme le nom du fichier ou le numéro de page, peuvent également être conservés pour retrouver la source de chaque fragment.
4. La recherche et la génération
Lorsqu'un utilisateur pose une question, celle-ci est transformée en embedding par le même modèle que celui utilisé pour indexer les documents. Le système compare alors ce vecteur avec ceux enregistrés dans la base.
Les fragments jugés les plus pertinents sont récupérés et transmis au modèle de langage avec la question initiale. Le modèle utilise ces éléments de contexte pour construire sa réponse.
3. Comprendre le rôle des embeddings
La recherche documentaire traditionnelle repose souvent sur la présence de mots identiques entre une question et un document. La recherche vectorielle fonctionne différemment : elle cherche à rapprocher des contenus dont le sens est similaire, même lorsque les formulations ne sont pas identiques.
Prenons un exemple. Un document contient la phrase « Le serveur dispose de huit gigaoctets de mémoire vive ». Un utilisateur demande : « Quelle est la quantité de RAM disponible ? »
Les termes employés ne sont pas exactement les mêmes, mais les deux formulations expriment une information proche. Les embeddings permettent de représenter cette proximité sémantique et de retrouver le passage correspondant.
Il faut cependant comprendre qu'un vecteur n'est pas une traduction du texte en langage machine au sens littéral. C'est une représentation mathématique construite par un modèle entraîné pour rapprocher certains contenus selon leur signification et leur contexte.
4. Les composants d'une architecture RAG
Un RAG n'est pas un logiciel unique. C'est une architecture qui associe plusieurs fonctions. Celles-ci peuvent être réunies dans une application ou réparties entre différents services indépendants.
| Composant | Fonction |
|---|---|
| Extracteur documentaire | Récupère le texte contenu dans les fichiers et les sources. |
| Découpage | Divise les documents en fragments exploitables. |
| Modèle d'embedding | Transforme les textes en vecteurs numériques. |
| Base vectorielle | Stocke les vecteurs et permet de rechercher les fragments proches d'une question. |
| Modèle de langage (LLM) | Interprète le contexte récupéré et produit la réponse. |
| Orchestrateur | Coordonne les opérations et transmet les informations entre les composants. |
Dans notre environnement LABO Web-Soul, ces fonctions peuvent être réparties entre plusieurs outils :
- Ollama : exécute les modèles d'embedding et de génération.
- Qdrant : assure le stockage et la recherche vectorielle.
- AnythingLLM : fournit une interface et prend en charge une grande partie de la coordination du RAG.
- Python : permet de développer notre propre orchestration et de contrôler directement les différentes opérations.
Ces outils ne sont pas interchangeables. Qdrant, par exemple, ne découpe pas les documents et ne génère pas de réponses. Il assure la gestion des vecteurs et leur recherche. De même, Ollama exécute les modèles, mais ne constitue pas à lui seul un système RAG complet.
5. Les paramètres qui influencent la qualité
La qualité d'un RAG ne dépend pas uniquement du modèle de langage. Elle résulte de plusieurs choix techniques qui interviennent à différentes étapes du traitement.
La qualité des documents
Un système RAG ne peut pas retrouver une information qui n'existe pas dans son corpus documentaire. Des documents incomplets, mal structurés ou contenant des erreurs peuvent donc compromettre la pertinence des réponses.
La taille des fragments
Des fragments trop petits risquent de perdre leur contexte. Des fragments trop volumineux peuvent contenir trop d'informations secondaires et compliquer la sélection des passages utiles. Il faut trouver un équilibre adapté à la nature des documents.
Le modèle d'embedding
Le modèle d'embedding influence directement la qualité de la recherche sémantique. Il doit être adapté à la langue, au type de contenu et aux ressources disponibles. Le même modèle doit être utilisé pour l'indexation et pour la vectorisation des questions.
La recherche des fragments
Le système doit sélectionner les passages les plus utiles à la question. Le nombre de fragments récupérés, les critères de similarité et les éventuels traitements complémentaires influencent le résultat. Une recherche trop large peut transmettre du bruit au modèle ; une recherche trop restrictive peut écarter une information nécessaire.
Le modèle de génération
Enfin, le modèle de langage doit exploiter correctement les extraits fournis. Il doit être capable de distinguer les informations présentes dans le contexte de ses connaissances générales et de signaler lorsqu'il ne dispose pas d'éléments suffisants.
6. Les limites du RAG
Le RAG améliore l'accès à des connaissances externes, mais il ne garantit pas automatiquement la fiabilité d'une réponse. Plusieurs limites doivent être prises en compte.
- La qualité des sources : une information erronée dans un document peut être reprise dans la réponse.
- Les erreurs de recherche : un fragment pertinent peut ne pas être retrouvé, ou un passage secondaire peut être sélectionné à sa place.
- La perte de contexte : un découpage mal adapté peut séparer des informations qui doivent être comprises ensemble.
- Les limites du modèle : même avec un contexte pertinent, le LLM peut mal interpréter les informations ou produire des affirmations non justifiées.
- La mise à jour documentaire : lorsqu'un document évolue, ses anciens fragments doivent être actualisés dans la base vectorielle.
- La confidentialité : les documents indexés peuvent contenir des données sensibles. Les accès aux fichiers, aux bases et aux interfaces doivent être protégés.
Un RAG doit donc être considéré comme un système d'accès et d'exploitation documentaire, et non comme une garantie de vérité. La traçabilité des sources et la vérification des réponses restent importantes, particulièrement dans un contexte professionnel.
7. RAG, entraînement et mémoire : trois notions différentes
Le RAG est parfois confondu avec l'entraînement d'un modèle ou avec sa mémoire conversationnelle. Ces mécanismes répondent pourtant à des besoins différents.
| Mécanisme | Ce qu'il apporte |
|---|---|
| Entraînement | Modifie les paramètres du modèle à partir de données d'apprentissage. |
| RAG | Fournit au modèle des informations externes sélectionnées au moment de la question. |
| Mémoire conversationnelle | Permet de conserver et de réutiliser des informations issues d'échanges précédents, selon les mécanismes de l'application. |
Le RAG ne rend donc pas le modèle plus intelligent en modifiant son entraînement. Il lui donne accès à un ensemble de connaissances complémentaires qu'il peut consulter à la demande. Cette séparation permet de mettre à jour les documents sans devoir réentraîner le modèle de langage.
À retenir
Le RAG associe une recherche documentaire à un modèle de génération. Les documents sont extraits, découpés en fragments, transformés en vecteurs puis stockés dans une base de recherche. Lorsqu'une question est posée, les passages les plus pertinents sont récupérés et transmis au modèle pour construire une réponse contextualisée.
Son intérêt réside dans la possibilité de fournir à une IA des connaissances spécifiques, évolutives et indépendantes de son entraînement. Sa qualité dépend toutefois de l'ensemble de la chaîne : documents, découpage, embeddings, recherche et génération.
Le RAG constitue ainsi une brique essentielle pour construire des assistants documentaires et des agents capables d'exploiter des connaissances propres à une organisation, sans devoir réentraîner systématiquement leurs modèles.