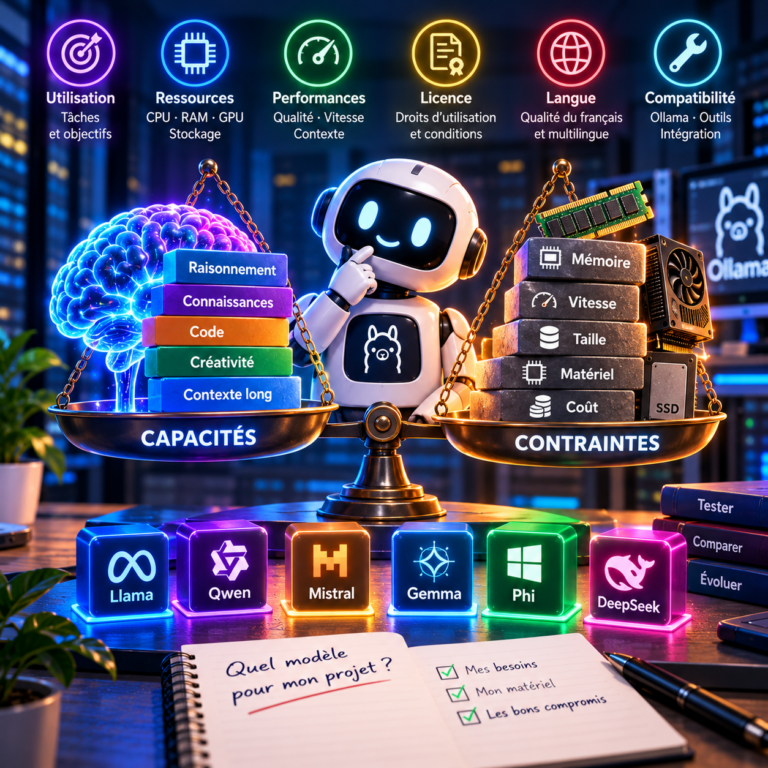
Choisir un modèle d'intelligence artificielle ne consiste pas simplement à télécharger le plus puissant ou le plus populaire. Le bon choix dépend de ce que l'on veut lui faire faire, du matériel disponible, de la qualité des réponses attendues et des contraintes d'utilisation.
Un modèle relativement compact peut suffire pour des tâches simples et fonctionner sur un petit serveur. Un modèle plus important peut être préférable pour des raisonnements complexes, du développement informatique ou des instructions exigeantes, mais il demandera davantage de ressources.Cette fiche présente les principaux critères permettant de comparer les modèles et de sélectionner celui qui correspond réellement à un projet.
1. Définir l'utilisation prévue
Avant de rechercher un modèle, commençons par définir les tâches que nous souhaitons lui confier. Les modèles ne possèdent pas tous les mêmes capacités et leurs résultats peuvent varier considérablement selon le type de travail demandé.
| Utilisation | Critère à privilégier |
|---|---|
| Questions et réponses courantes | Qualité des réponses et maîtrise des instructions |
| Rédaction et synthèse | Qualité du texte, cohérence et maîtrise du français |
| Programmation | Compréhension du code, génération et correction |
| Raisonnement complexe | Capacité à traiter des problèmes comportant plusieurs étapes |
| Automatisation par des agents IA | Respect des instructions et compatibilité avec l'utilisation d'outils |
| Analyse de documents | Compréhension du contenu et capacité à exploiter un contexte fourni |
Ces catégories ne sont pas exclusives. Un même modèle peut accomplir plusieurs de ces tâches, mais il n'est pas nécessairement aussi performant dans chacune d'elles.
La première question à se poser est donc simple : quelle tâche doit-il accomplir correctement, et non quelle intelligence artificielle est considérée comme la meilleure en général ?
2. Comprendre la taille d'un modèle
Les modèles de langage sont souvent désignés par leur nombre de paramètres, exprimé en milliards. On rencontre ainsi des modèles de 1,7 milliard, 4 milliards, 8 milliards ou plusieurs dizaines de milliards de paramètres.
Les paramètres sont des valeurs numériques apprises pendant l'entraînement du modèle. Leur nombre donne une indication de sa taille, mais ne suffit pas à déterminer sa qualité. L'architecture, les données d'entraînement, les méthodes d'apprentissage et la spécialisation du modèle jouent également un rôle important.
| Taille indicative | Positionnement |
|---|---|
| Petit modèle | Point de départ pour des tâches courantes et des ressources limitées |
| Modèle intermédiaire | Compromis possible entre capacités, consommation et vitesse |
| Grand modèle | Peut offrir de meilleures capacités sur certaines tâches, au prix de ressources supplémentaires |
Ces catégories restent indicatives : il n'existe pas de frontière universelle séparant les petits, moyens et grands modèles. Un modèle spécialisé de petite taille peut également surpasser un modèle plus volumineux sur une tâche particulière.
Le nombre de paramètres n'est donc pas un classement de qualité. Il faut confronter les capacités annoncées aux besoins réels du projet et aux ressources disponibles.
3. Vérifier les ressources matérielles
Un modèle doit pouvoir être chargé en mémoire pour être utilisé. Selon la configuration, cette mémoire peut être celle du processeur, celle de la carte graphique ou une combinaison des deux.
Pour un déploiement local ou sur VPS, il faut notamment prendre en compte :
- La mémoire vive (RAM) : elle participe au chargement du modèle et au traitement des requêtes lorsque l'inférence utilise le processeur.
- La mémoire vidéo (VRAM) : elle est importante lorsque le modèle est exécuté sur un GPU.
- Le processeur : ses performances influencent notamment la vitesse de génération lorsqu'une partie importante du calcul est effectuée sur CPU.
- Le stockage : les fichiers du modèle, ses différentes variantes et les données associées occupent de l'espace disque.
Il faut également conserver des ressources pour le système d'exploitation, Docker et les autres applications hébergées sur le serveur. Un modèle qui utilise presque toute la mémoire disponible peut ralentir les autres services ou provoquer des erreurs par manque de mémoire.
Les besoins réels dépendent du modèle, de sa quantification, de la longueur du contexte et des paramètres d'exécution. Il est donc préférable de consulter les informations du modèle et de mesurer sa consommation plutôt que de se fier uniquement à une estimation générale.
4. Comprendre la quantification
La quantification consiste à utiliser une représentation numérique moins précise pour les paramètres d'un modèle. Elle permet souvent de réduire la taille des fichiers et la mémoire nécessaire à l'exécution.
Deux variantes d'un même modèle peuvent ainsi présenter des tailles et des besoins matériels différents. En contrepartie, une quantification plus agressive peut entraîner une dégradation de certaines capacités. L'importance de cette dégradation dépend du modèle et de la méthode employée.
Dans une bibliothèque comme Ollama, certaines variantes sont déjà préparées pour faciliter leur téléchargement et leur utilisation. Il faut vérifier les informations de la variante choisie, car le nom d'un modèle ne suffit pas toujours à connaître précisément sa représentation et sa consommation.
Pour un premier déploiement, l'objectif est de trouver un compromis acceptable entre qualité des réponses, mémoire utilisée et vitesse de génération.
5. Examiner les capacités et les limites
La taille ne dit pas tout. Avant de télécharger un modèle, consultons sa fiche technique ou sa documentation officielle. Ces ressources permettent notamment de connaître ses capacités annoncées, son architecture, les langues prises en charge, les tâches visées et les éventuelles restrictions.
Quelques points méritent une attention particulière :
- Les langues: si les échanges doivent se faire en français, testons la qualité réelle des réponses en français.
- Le contexte: la longueur de contexte indique la quantité de texte que le modèle peut prendre en compte dans une requête. Une limite élevée ne garantit pas que toutes les informations seront exploitées correctement.
- Le raisonnement: les performances sur les problèmes complexes varient selon les modèles et les tâches.
- Le code et les outils: si le modèle doit participer à des automatisations, vérifions ses capacités de génération de code ou d'utilisation d'outils.
- Les modalités: certains modèles sont conçus pour traiter du texte uniquement, tandis que d'autres peuvent également exploiter des images, de l'audio ou d'autres types de données.
Les caractéristiques annoncées par l'éditeur constituent un point de départ. Elles doivent être complétées par des tests correspondant à l'utilisation prévue, car les résultats peuvent différer selon les instructions, les données et les paramètres d'exécution.
6. Vérifier la licence et les conditions d'utilisation
La disponibilité d'un modèle au téléchargement ne signifie pas que son utilisation est libre de toute condition. Il faut distinguer l'accès aux fichiers du modèle, les droits accordés par sa licence et les conditions applicables à son utilisation.
Avant de retenir un modèle pour un projet, vérifions :
- la licence indiquée dans la fiche officielle ;
- les restrictions éventuelles liées à l'utilisation ou à la redistribution ;
- les conditions particulières applicables à un usage professionnel ou commercial ;
- les éventuelles obligations associées à la diffusion d'une application intégrant le modèle.
Il ne faut pas confondre un modèle à poids accessibles avec un logiciel dépourvu de restrictions. Les conditions varient selon les modèles et doivent être vérifiées individuellement.
7. Comparer les modèles disponibles
Une fois les besoins et les contraintes définis, nous pouvons rechercher des modèles candidats. Plusieurs ressources permettent de consulter les modèles disponibles, leurs variantes et leurs caractéristiques.
- Bibliothèque officielle Ollama : rechercher des modèles utilisables avec Ollama et consulter leurs variantes.
- Bibliothèque de modèles Hugging Face : explorer de nombreux modèles, filtrer par tâche et consulter les fiches techniques.
- Documentation sur les fiches de modèles : comprendre les informations présentées dans les model cards, notamment les tâches visées et les licences.
Ces ressources ne proposent pas toutes les mêmes formats ni les mêmes méthodes d'installation. Pour utiliser un modèle avec Ollama, vérifions qu'il est disponible dans sa bibliothèque ou que sa méthode d'intégration est compatible avec notre environnement.
Ne nous limitons pas à un classement général ou à un score de benchmark. Les résultats publiés peuvent être utiles pour comparer des capacités précises, mais ils ne remplacent pas un essai sur nos propres tâches.
8. Tester avant de décider
Le moyen le plus fiable de départager quelques modèles consiste à leur soumettre les mêmes demandes et à comparer les résultats. Cette démarche permet d'évaluer leur utilité dans notre environnement réel.
Étape 1. Définir trois à cinq tâches représentatives de l'utilisation prévue : une question courante, une demande de synthèse, une instruction complexe ou un exemple de code, selon les besoins du projet.
Étape 2. Soumettre les mêmes instructions à chaque modèle candidat, avec des paramètres aussi comparables que possible.
Étape 3. Évaluer la pertinence des réponses, le respect des instructions, les erreurs factuelles, la qualité du français et la capacité à traiter le problème demandé.
Étape 4. Observer le temps de réponse, la vitesse de génération, la consommation de mémoire et la stabilité du service.
Étape 5. Retenir le modèle qui répond le mieux aux besoins, en tenant compte des ressources et des contraintes d'utilisation.
Un modèle plus lent peut être préférable si ses réponses sont nettement meilleures pour les tâches importantes. À l'inverse, un modèle rapide et compact peut être plus adapté à une automatisation répétitive qui exige des réponses courtes.
9. Le choix du modèle dans notre LABO Web-Soul
Dans notre plateforme, nous commençons avec Ollama et un modèle de petite taille afin de valider le fonctionnement du moteur IA avant d'ajouter les autres composants. Ce choix permet de vérifier le téléchargement du modèle, la génération de texte et l'accès à l'API sans commencer par un modèle particulièrement exigeant.
Nous avons retenu qwen3:1.7b comme modèle de départ. Il s'agit d'un choix de test, pas d'une conclusion selon laquelle Qwen serait le meilleur modèle pour tous les usages.
La famille Qwen3 comprend plusieurs tailles de modèles. La fiche officielle de Qwen3-1.7B présente notamment ses caractéristiques et son contexte maximal annoncé. Ces informations permettent d'évaluer le modèle, mais elles ne suffisent pas à prédire ses performances sur notre VPS.
Une fois l'environnement opérationnel, nous pourrons comparer d'autres modèles sur les mêmes tâches et mesurer les différences de qualité, de vitesse et de consommation. Le choix pourra ainsi évoluer avec les besoins du LABO et les ressources disponibles.
10. Ne pas confondre modèle de langage et modèle d'embedding
Dans un projet qui exploite des documents, un modèle de langage n'est pas le seul composant à choisir. Un système de recherche documentaire peut également utiliser un modèle d'embedding pour transformer des textes en représentations numériques comparables.
Le modèle de langage sert notamment à produire une réponse. Le modèle d'embedding sert à représenter les contenus afin de faciliter la recherche de passages pertinents. Ils remplissent donc des fonctions différentes et ne sont pas nécessairement interchangeables.
Lorsque nous mettrons en place le RAG dans LABO Web-Soul, nous devrons sélectionner et tester le modèle d'embedding en tenant compte de la langue des documents, de la qualité de la recherche et des contraintes matérielles. Le choix du modèle de langage ne règle pas automatiquement cette question.
À retenir
Le choix d'un modèle d'IA repose sur plusieurs critères : la tâche à accomplir, les capacités du modèle, les ressources matérielles, la vitesse attendue, la licence et les résultats obtenus lors de tests concrets.
Il n'existe pas un modèle universellement meilleur pour tous les projets. La bonne méthode consiste à définir les besoins, sélectionner quelques candidats, vérifier leurs caractéristiques et les comparer sur des tâches représentatives.
Dans LABO Web-Soul, nous commençons avec un modèle compact pour valider l'installation d'Ollama. Ce choix constitue une première étape technique. Il ne nous empêche pas de tester ultérieurement des modèles plus performants ou mieux adaptés à des usages spécialisés.